精读 · BV1fMyWBgERM
B 站入门合集精读
从「Triton 是什么」走到融合 Softmax、FlashAttention 思想、Dropout、带反向的 LayerNorm。下面是能面试口述的压缩版;细节代码仍以本地笔记为准。
1–3 · 地图:为什么用 Triton
CUDA 让你管 thread / warp / shared;Triton 让你管 tile:一块数据的 offset、mask、算法。Compiler 负责把一个 program 映射到硬件。云端 GPU 只是跑通环境——过关标准是本地/云上能 import triton 并跑通 vector add。
@triton.jit:Python 外观,编译进 GPU kerneltl.program_id(0):第几块砖(tile id),不是 CUDA threadIdx- 求职叙事:手写 tile 证明你懂访存;compile 证明你懂框架自动生成
4 · 向量加法:三件套
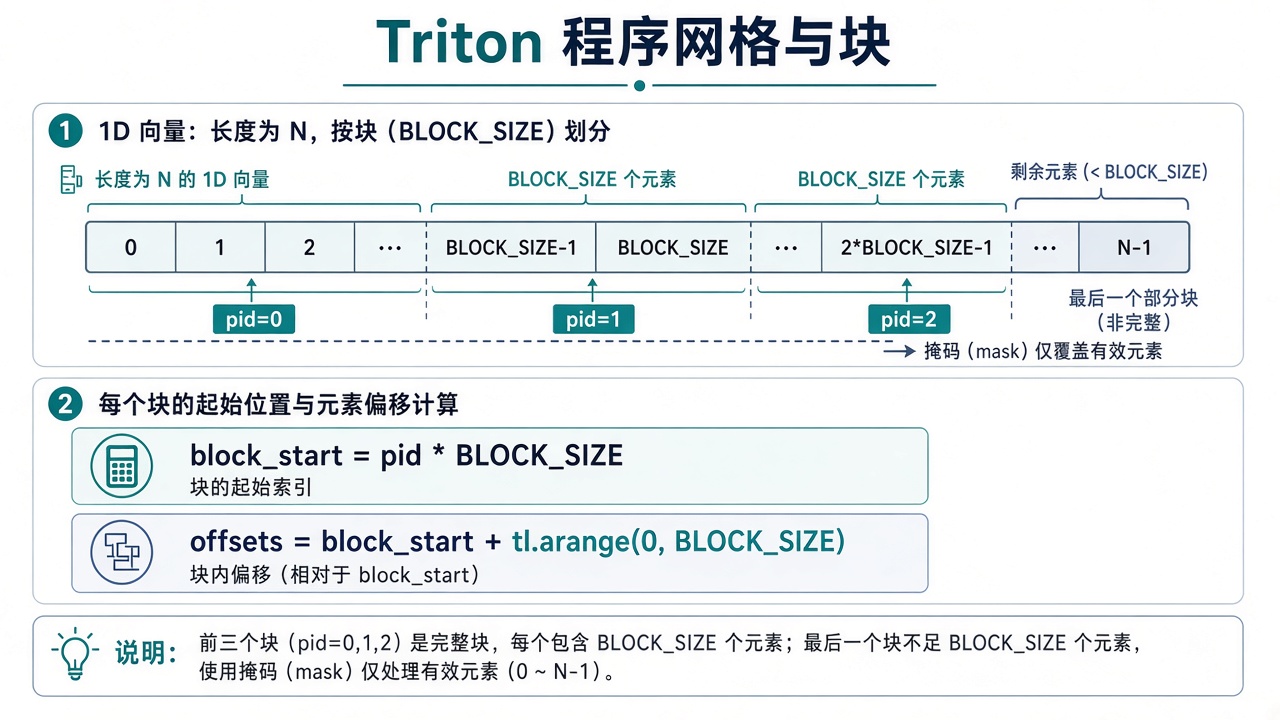
pid = tl.program_id(0)
offsets = pid * BLOCK_SIZE + tl.arange(0, BLOCK_SIZE)
mask = offsets < n
x = tl.load(x_ptr + offsets, mask=mask)
y = tl.load(y_ptr + offsets, mask=mask)
tl.store(out_ptr + offsets, x + y, mask=mask)
口述三句:grid = cdiv(n, BLOCK);offsets 从 pid 算;mask 挡越界。改 BLOCK_SIZE 只改「砖多大」,算法不变。
5 · Softmax:为什么要融合
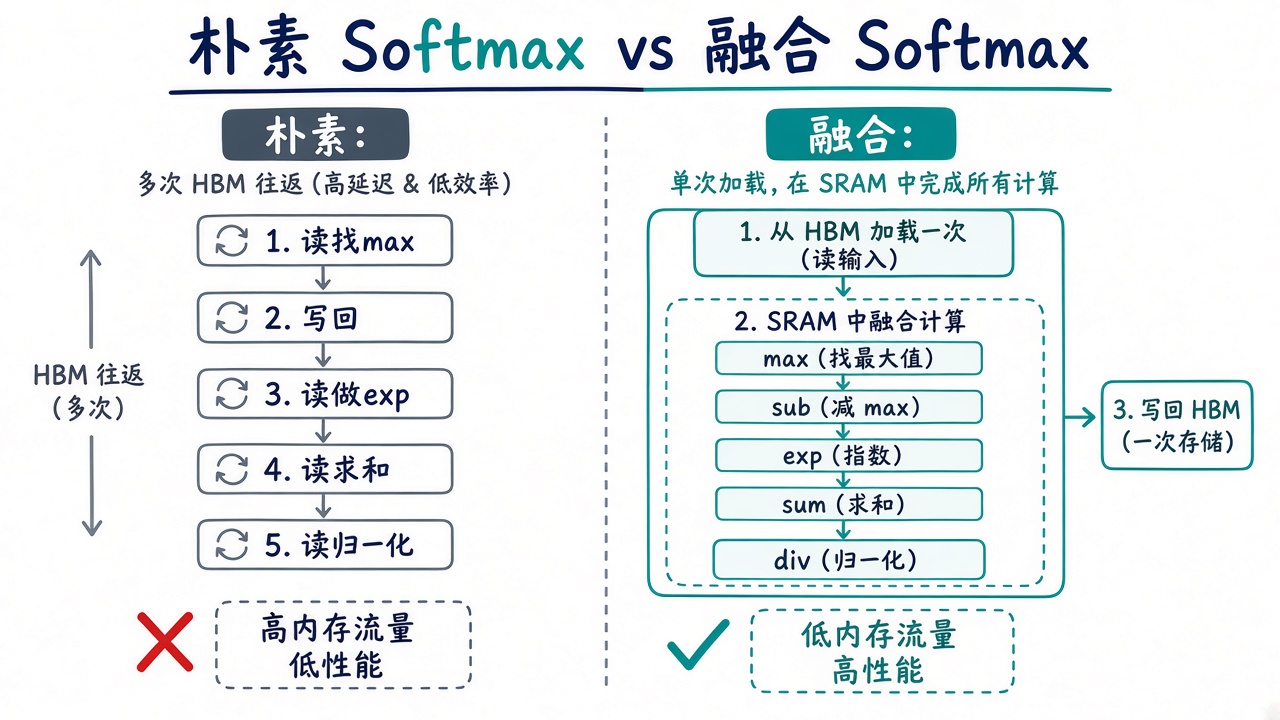
数值稳定 Softmax:m = max(x),e = exp(x-m),y = e / sum(e)。朴素实现每次扫一遍全局内存;融合 kernel 在同一 program 里做完 max/sum/normalize,省的是中间张量进 HBM。
6 · Matmul:tiling 直觉
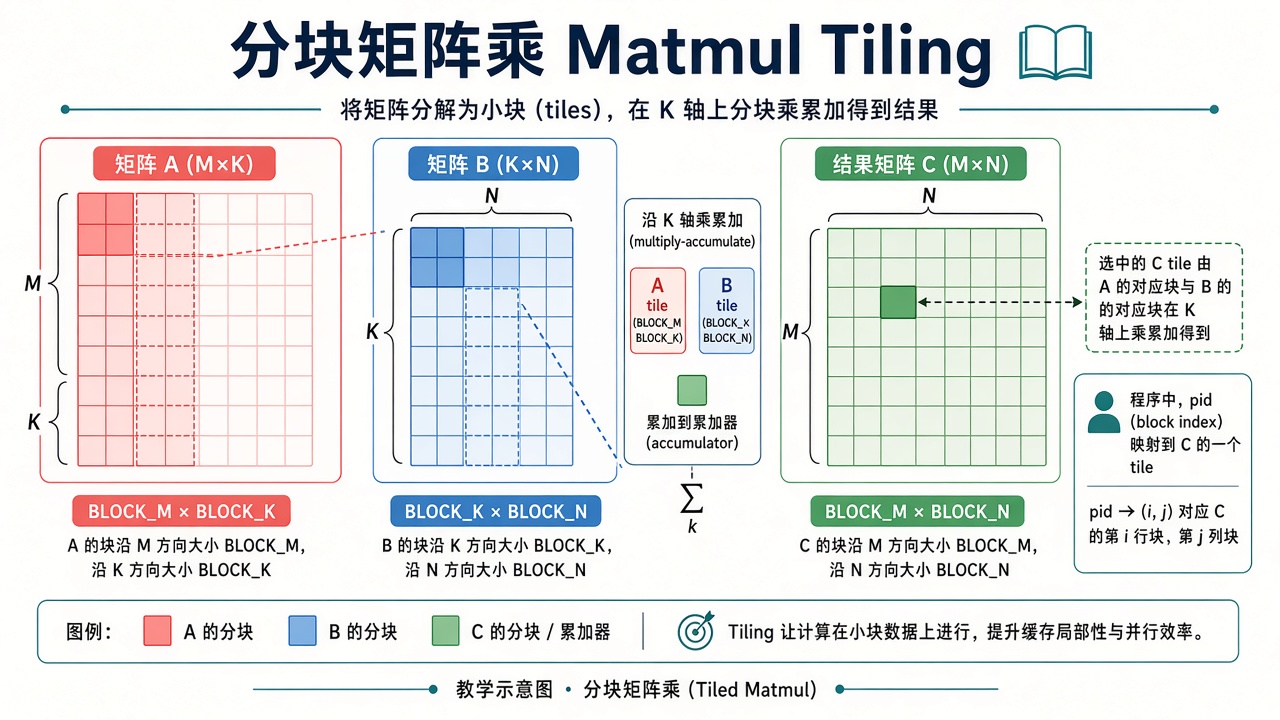
二维 pid(或一维拆成 row/col tile)各写一块 C。内层沿 K 以 BLOCK_K 步进:load A 片、load B 片、累加到寄存器/片上累加器,最后 store C tile。面试关键词:tiling + 数据复用,不是「Python 比 CUDA 好看」。
7 · Dropout
训练期按概率置零并 scale。Triton 侧常见写法:用 philox 类 PRNG 按 offset 出随机位,mask 与业务 mask 相与。要点:
- 随机性必须可复现(seed + offset)
- 和融合算子叠在一起时,仍尽量少写中间激活
- 推理关闭 dropout——kernel 路径要能切
8 · LayerNorm(含反向直觉)
行内:均值、方差、仿射 y = γ(x-μ)/σ + β。前向可一行一个 program;反向要对 γ/β 与输入 x 求梯度,往往再扫、再归约。通关标准:能画出前向数据流,并说出反向多出来的归约维。
9–10 · FlashAttention 思想
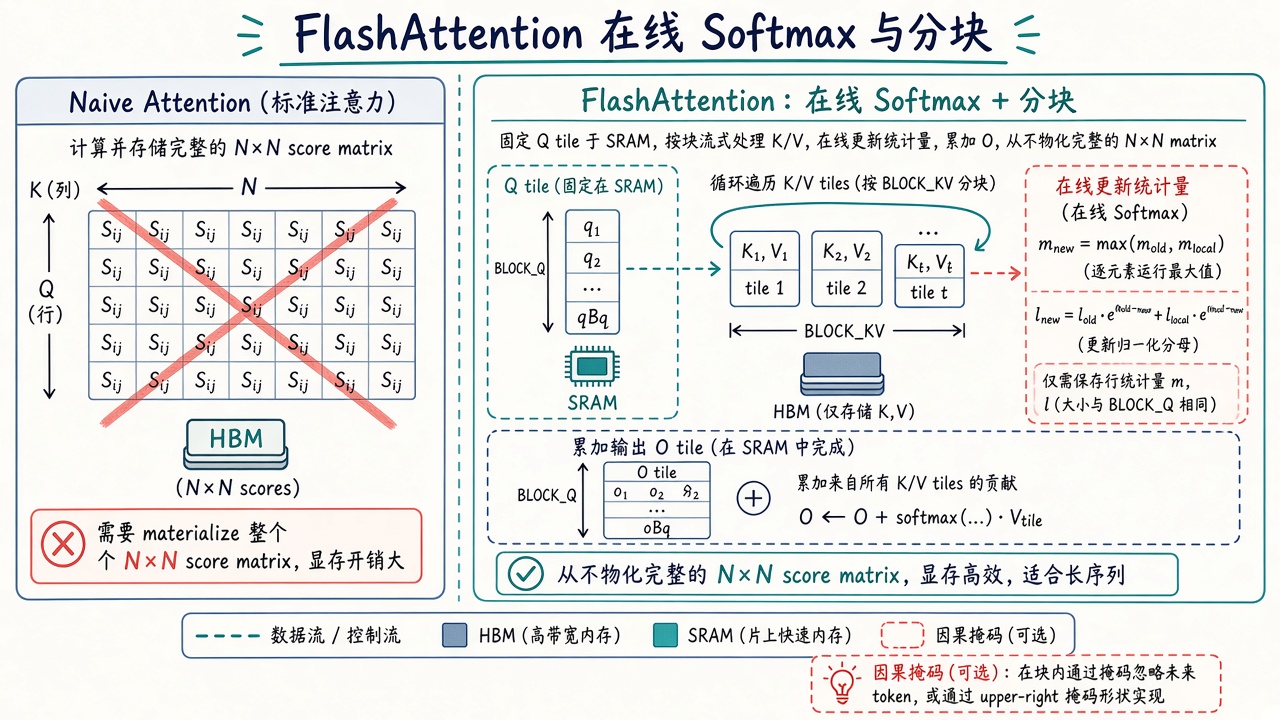
经典 Attention 物化 S = QKᵀ(序列平方级),带宽炸。FA:把 Q/K/V 切块,块内算分数并用 online softmax 更新输出累加器;不写全量 S。Triton 教学实现通常先 IO-aware 正确性,再谈 pedantic 边界与性能调参。
通关口述(合集)
- program_id / BLOCK / mask 各解决什么
- 融合 Softmax 省的是哪次 HBM
- Matmul 为什么切二维 tile + K 分块
- FA 相对朴素 Attention:不物化哪张表