精读 · GPU MODE Lecture 29
Triton Internals
面试被问「Triton 编译器到底干了什么」时用这篇。目标不是背 pass 名字,而是能画出从 @triton.jit 到 PTX 的主干,并知道每一层在抽象什么。
流水线一张图
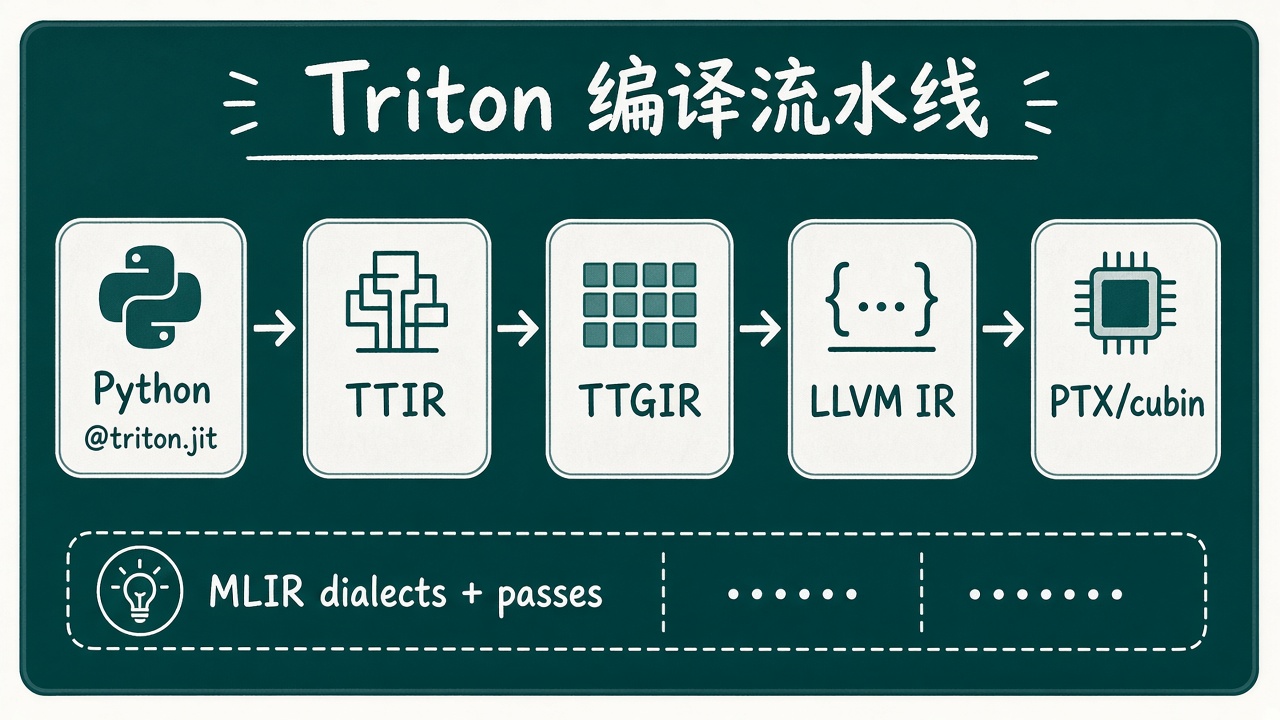
@triton.jit 源码
    → 前端:Python AST / 特化常量(constexpr、BLOCK_*)
    → TTIR:算子级 IR(load/store/dot/reduce…)仍偏「tile 语义」
    → TTGIR:更贴近 GPU(layout、pipeline、与目标相关的 lowering)
    → LLVM IR → PTX → 驱动装载
每一层你该记住的一句话
| 层 | 记住什么 |
|---|---|
| JIT 特化 | BLOCK、dtype、有时甚至形状进编译期,换一套就重编译 |
| TTIR | 还在「向量/块」语言里;优化融合、死代码多发生在附近 |
| TTGIR | 开始谈 layout、多缓冲、与硬件流水;性能秘密多在这 |
| LLVM/PTX | 和常规 GPU 后端汇合;这时已接近 CUDA 编译产物 |
和「手写 CUDA」的对照
CUDA:你直接或间接决定 thread 映射与很多 shared 细节。Triton:你在 TTIR 语义写算法,layout / coalescing / 部分软件流水由后续 pass 填。所以:
- 写错 offset/mask → 结果错(你的责任)
- BLOCK 选烂、layout 不友好 → 慢(你调参 + compiler 能力)
- 同算法 CUDA 手调极致 vs Triton:峰值看场景,工程效率通常 Triton 胜
调试时看哪一层
- 正确性:先怀疑自己的 ptr/mask/grid(别先怪后端)
- 慢:看 autotune 配置、是否多余 load、能否融合;必要时开编译中间 dump
- 和 Inductor 比:生成代码啰嗦但结构仍是 pid + load/store;会读生成文本就够用
国产类 Triton 叙事:对标的是「tile 语言 + 多层 IR + 落到自研 ISA」这条链,不是只抄 Python API。论证见 ecosystem.html。
通关口述
- 默画:JIT → TTIR → TTGIR → LLVM → PTX
- 举一例:改 BLOCK_SIZE 为什么可能触发重编译
- 一句话区分「你写的」和「pass 填的」